简易网页抓取与MDX教程制作
1、 获取网站首页,新建一个TXT文件,写入所有待抓取词条的URL地址。
2、 将文本文件命名为download.txt,并将其与wget.exe程序置于同一目录下(如D:DOPF)。若下载的wget可执行文件名称包含版本号(例如wget-1.21.4.exe),请先将其重命名为wget.exe。随后,打开命令提示符(cmd.exe),依次执行以下操作:切换至目标目录——输入cd /d D:DOPF,再运行下载命令——键入wget -i download.txt。该命令将按文本文件中列出的URL地址批量下载资源。
3、 下载处理后,共获得16698个链接。
4、 同样使用 wget -i download.txt 命令批量下载文件中列出的所有 HTML 页面,后续操作将变得非常简单。
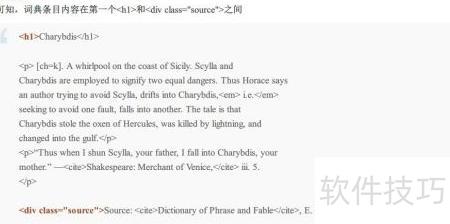
5、 通过文本分析发现,词典条目内容位于首个标签与标签之间的区域。
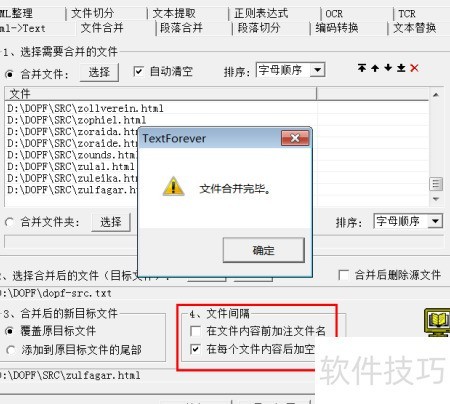
6、 借助TextForever工具提取文本内容。
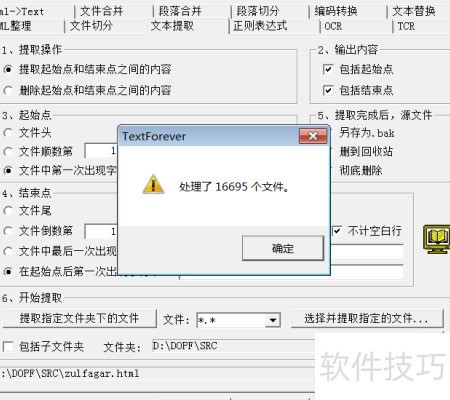
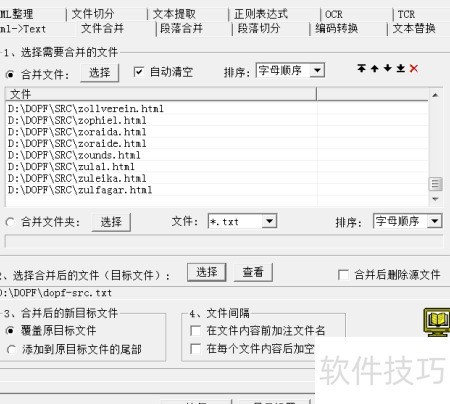
7、 提取完成后,共合并生成16695个HTML文件。在制作这本词典的过程中,我曾考虑是否需在文件内容前添加文件名。虽然某些场景下此举有助于关键词提取,但经反复测试验证,最终确定应在文件内容末尾统一添加一个空行,以确保格式规范、解析稳定且兼容性更佳。
8、 获取dopf-src.txt文件,对其进行处理,生成符合MDX格式构建要求的文本文件。
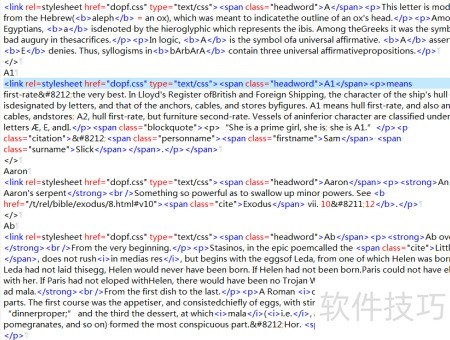
9、 MDX合并后的文本呈现如下:
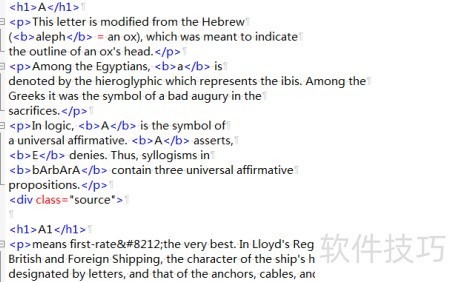
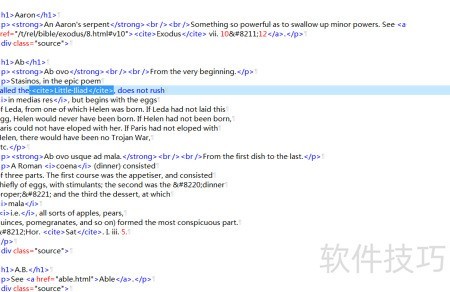
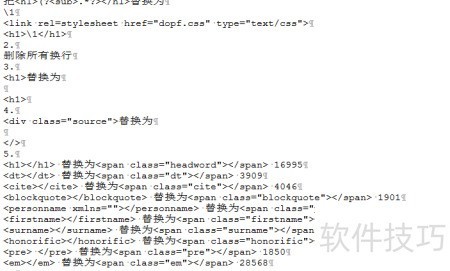
10、 词典源文件为XML格式,但MDict桌面版原生不支持XML+CSS渲染(需升级内核方可实现)。因此,需将XML标签统一转换为标准HTML标签。经过一系列格式转换与结构优化,最终生成兼容性良好的HTML文本。
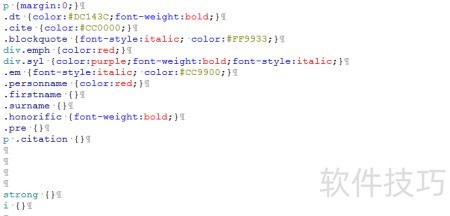
11、 编写CSS
12、 途中虽遇小问题,但逐一解决,最终顺利完成。
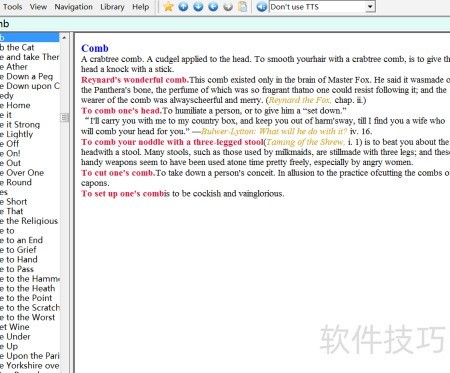
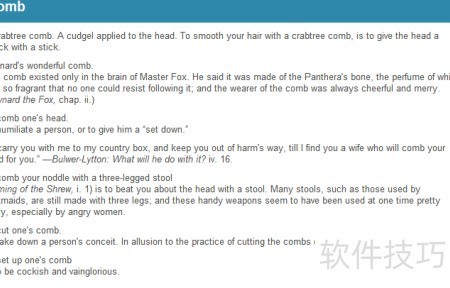
13、 看起来是否比在线版更顺眼些?