

绪:
1、 算法概述
2、 K-means是一种常用的无监督聚类算法。
3、 将n个对象依据其属性划分为k个互不重叠的子集,其中k小于n。
4、 该方法与混合正态分布的EM算法相似,均旨在识别数据中天然形成的簇中心。它将对象属性视为空间向量,优化目标是使各簇内样本到其质心距离的平方和最小化。
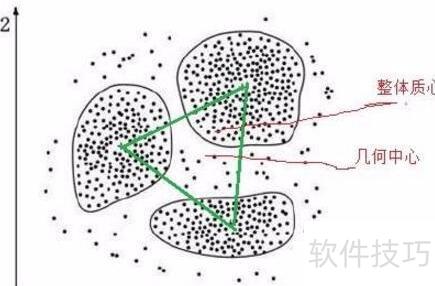
5、 设有k个群组Si(i=1,2,…,k),μi表示群组Si中所有元素xj的几何中心,即该群组的重心。
6、 Lloyd算法
7、 K均值聚类算法诞生于1956年,最广泛应用的形式是基于迭代优化的劳埃德算法,通过不断调整聚类中心与样本归属,逐步提升聚类质量。
8、 劳埃德算法首先将输入数据点随机或依据启发式策略划分为k个初始簇。随后,计算每个簇的质心(即该簇所有点的几何中心),再将每个点重新分配至距离最近的质心所属簇中。完成一次重分配后,更新各簇的新质心位置。此过程持续迭代:计算质心→重新聚类→更新质心,直至簇结构稳定,即所有点所属簇不再变化,质心位置亦不再发生移动,算法即告收敛。
9、 劳埃德算法常被用于求解k均值聚类问题,但本质上是一种启发式方法,并非严格保证收敛至全局最优解。其结果高度依赖初始聚类中心的选择:若起始点设置不当,算法可能陷入局部最优,导致最终划分与真实最优解存在偏差,甚至产生多个不同质量的最优结果。
10、 尽管存在变异形式,劳埃德算法仍广受青睐,主要得益于其在实际应用中极快的收敛速度——通常迭代次数远低于数据点总数。然而,大卫·亚瑟与谢尔盖·瓦西列夫斯基近期研究指出,在某些特殊构造的点集上,k均值算法可能需要超多项式时间才能完成收敛,这揭示了该算法在最坏情况下的理论局限性,也促使学界进一步探索其稳定性与效率边界。
11、 已有类似K均值的算法被用于处理原始数据的子集计算。
12、 该算法无法确保获得全局最优解,所得结果质量高度依赖于初始聚类中心的选择。因其计算效率高,实践中常采用多次随机初始化并运行算法,最终选取目标函数值最优的一次结果作为最终解。
13、 K均值算法存在两个主要局限:一是需预先指定聚类数量k,若取值不当易导致结果不佳;二是默认以均方误差作为衡量簇内离散程度的唯一标准,可能不符合实际需求。
14、 算法原理
15、 聚类算法依据数据特征识别相似性,将相近样本归为同一簇,其核心是通过距离度量来刻画数据间的相似程度。
16、 K-means聚类算法流程
17、 首先随机选择k个初始中心点,再将所有样本点分配至最近的中心点,形成初始的k个簇。
18、 对各类别求均值,再将各点归入距离最近的均值中心。
19、 重复此过程,直至各点归属稳定不变。
20、 下图展示了K-means聚类算法的示意图。
21、 SAS平台上的K均值聚类算法实现
22、 K-means聚类分析可通过SAS中的proc fastclus过程实现。
23、 主要涉及两个方面。
24、 在聚类分析的初始阶段,凝聚点的确定方式直接影响后续聚类结果的稳定性和合理性。系统提供了多种设定初始凝聚点的策略,以适应不同分析需求和数据特征。
25、 当采用随机初始化方式(即设定replace=random)时,程序将从全部有效观测中随机抽取指定数量的样本作为初始凝聚点,该数量由maxclusters参数决定。若分析人员具备领域经验,对数据结构有较深入理解,也可借助先验知识自主设定初始分类方案。此时,可通过seed=dataset选项,引导程序从指定数据集中读取前k个完整观测,作为预设的初始凝聚点,从而提升聚类过程的可控性与可解释性。
26、 此外,系统还内置了一种自动化选取机制,适用于缺乏明确先验信息的情形。该方法需同时指定maxclusters与radius两个关键参数:前者定义最终凝聚点的最大数量;后者则设定了任意两个凝聚点之间必须保持的最小欧氏距离阈值。默认设置为maxclusters=100、radius=0,即直接选取数据集中前100个完整观测作为初始候选。具体操作流程为:首先选定首个完整观测作为第一个凝聚点;随后逐个遍历其余观测,一旦发现某观测与已有凝聚点的距离均超过radius,则将其纳入凝聚点集合;此过程持续进行,直至凝聚点数量达到maxclusters上限或所有观测均已考察完毕。
27、 当新观测满足完整且与所有现有凝聚点距离均大于radius,但凝聚点总数已达上限时,系统将启动替换评估机制。该机制包含两类判断逻辑:其一为最近两凝聚点替换检验,即比较当前观测与最近两个凝聚点之间的最小距离,与这两个凝聚点彼此间的距离大小关系,若前者更大,则用当前观测替代其中距其更远的那个凝聚点;其二为最近凝聚点替换检验,即考察当前观测到其余凝聚点的最小距离,是否大于其最近凝聚点到其他凝聚点的最小距离,若成立则执行替换。用户可通过replace参数灵活控制该机制的启用程度:none表示完全跳过替换步骤;part仅执行第一类检验;full(默认)则两类检验均启用。整个过程兼顾效率与稳健性,确保初始凝聚点分布更具代表性与区分度。
28、 另一项关键操作涉及分类过程中的凝聚点更新机制。系统默认采用批量更新方式:首先选定一组初始凝聚点,随后将全部观测样本依据其与各凝聚点的最近距离划入对应类别;接着计算每一类的几何中心,并将其作为新一轮迭代的凝聚点。若新旧凝聚点位置完全一致,则算法终止;否则重复上述归类与更新步骤。与此不同,逐个更新法在每次单个观测样本重新归类后,即刻调整所属类别的凝聚点。这种即时更新要求系统实时检验所有凝聚点是否仍满足预设的半径约束条件。一旦发现任意两类凝聚点间距小于该半径阈值,系统将自动合并这两类,以其联合重心作为新类的凝聚点,并持续执行此类合并与重心重算,直至所有凝聚点间距均符合半径要求。如需启用逐个更新模式,须在指令中明确指定drift参数。
29、 K-中心点聚类算法
30、 K-means算法易受异常值影响,因均值对离群点敏感;改用K中值法可提升聚类鲁棒性,因其以中位数替代均值,有效削弱异常点干扰。
31、 PAM(围绕中心点划分)算法是K-medoids聚类方法的核心基础,通过迭代优化选取实际样本作为聚类中心。
32、 基本流程如下
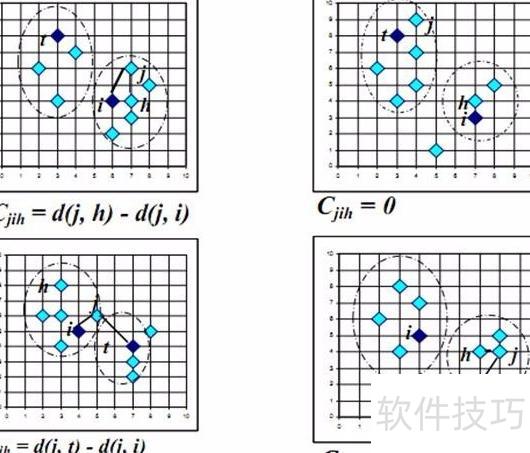
33、 算法初始随机选取k个对象作为聚类中心,其余对象依据距离最近原则被分配至相应中心。随后,随机选取一个非中心对象尝试替换某个现有中心,并计算此次替换后所有对象到其归属中心的总距离变化量。整个过程持续迭代:不断交换中心与非中心对象,评估每次交换对目标函数(即簇内平方误差和)的影响。仅当替换无法进一步降低目标函数值时,算法终止。具体替换操作中,以非中心点h替代中心点i时对对象j的代价变化所示。
34、 CLARAN聚类算法
35、 PAM算法伸缩性差,需穷举所有替换方案,仅适用于小规模数据的聚类分析。
36、 为提升算法可扩展性,研究者提出了CLARAN算法,其核心思想是……
37、 从总体数据中多次随机抽样,对每个样本运行PAM算法获取K个中心点;综合各次结果,选取最优解作为最终聚类中心。
38、 CLARAN算法的聚类效果受样本质量影响较大。
39、 为提升PAM与CLARAN算法的聚类效果,研究者在CLARAN基础上进一步提出了CLARANS算法。该算法最显著的特点在于彻底摒弃了固定样本集的限制,全程采用随机抽样方式动态构建和更新数据子集,从而增强搜索的灵活性与全局探索能力。其核心思想是将每一组由k个中心点构成的解视为图中的一个节点;若两个节点间有k?1个中心点完全相同,则视二者为相邻节点。用户需预先设定两个关键参数:最大邻域搜索次数与最多允许发现的局部最优解数量。算法启动后,首先随机选取一个初始解作为当前节点,随后在其邻域中反复随机选取邻居解,并评估目标函数值是否下降;一旦发现更优解,即以该邻居替代当前节点,并重启邻域搜索;若在达到最大邻域搜索次数后仍未找到改进解,则判定当前节点为一个局部最优解。此后,算法再次随机生成新的起始解,重复上述过程,直至累计获得指定数量的局部最优解。最终,通过比较所有局部最优解的目标函数值,选取最优者所对应的k个中心点作为最终聚类结果,进而自然划分出k个簇。尽管CLARANS在聚类质量上表现优异,但因频繁的随机采样与邻域遍历,其时间与空间复杂度较前代算法明显上升。


